ラベル python の投稿を表示しています。 すべての投稿を表示

2022年8月27日土曜日

画像生成AI「Stable Diffusion」の作例を呪文(prompt)とともに紹介します

 最近オープンソース化して話題の画像生成AI「Stable Diffusion」を使ってみたので、呪文(prompt)とともに載せてみます。

 Stable Diffusionというのは、簡単に言うと、文章を入力すると画像を生成してくれるAIです。
 オープンソース化されたので自分のパソコンにインストールすることもできますが、ハードウェア環境を整えなくちゃいけないので(GPUがないと生成にかなり時間がかかる)、とりあえず開発元のWebサービスDream Studioで試してみたら、これがとても面白い。
 どうにか自分のPCで使えないかと調べていたらGoogle Colabで使えるようなので、試してみました。Google Colabというのは、Googleが機械学習の教育及び研究用に提供しているGoogle のクラウド サーバーでコードを実行する開発環境で、無料でも使えます(課金すると使えるGPUとかメモリ量とかがパワーアップ)。あんまり使いすぎると使用制限がかかりますが。

 Stable Diffusionの導入手順は【イラストAI】コピペ可!Stable Diffusionの簡単な使い方【コードつき】 | おっさんゲーマーどっとねっとおっさんゲーマーどっとねっと を参考にしました。Google Colabの使用方法とPythonの基礎の基礎を知っていれば15分もあれば可能かと。
 なお、使用する学習済みモデルは上の参考サイトから変更しています。

import torch 
from diffusers import StableDiffusionPipeline 

pipe = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4", use_auth_token=True)

 参考サイトだと下のようになっているのですが、私は上のようにしています。GPUのメモリが10GB未満のときは下のように半精度(float16)のモデルの使用が推奨されているのですが、Google Colabの場合は通常のものが使えるので、上で大丈夫でした。

pipe = StableDiffusionPipeline.from_pretrained("CompVis/stable-diffusion-v1-4", revision="fp16", torch_dtype=torch.float16, use_auth_token=True)

 参考にオプション類の指定は次のような感じ。公式サービスのDream StudioではSmaplerも指定できるのですが、Google Colabでのやり方は調べきれていません。

from torch import autocast
from IPython.display import display

prompt = "a cute cat in a hat"

# heightとwidthで縦横サイズ(8の倍数で)を指定。デフォルトは縦横とも512。あまり大きくするとメモリが足りず実行できない。
# 512を下回ると、画像の品質が低下する場合がある。
# 512を超えると、画像領域が繰り返される(画像全体の首尾一貫性がとれなくなる)。
# 正方形でない画像を作成するには、縦横のいずれかに512を使用し、もう一方にそれより大きな値を使用するのがおすすめ。それでも腕が増えたりすることが頻発するが。
# guidance_scale: promptに記載したテキストへの忠実性。デフォルトは7.5。一般に7から8.5ぐらいがよいらしい。
# num_inference_steps: 一般にステップ数が多くなると結果は良くなるが生成に要する時間がよりかかる。デフォルトは50。

with autocast("cuda"):
  image = pipe(prompt, height=768, width=512)["sample"][0]
  display(image)
  image = pipe(prompt, height=768, width=512, guidance_scale=7, num_inference_steps=50)["sample"][0]
  display(image)
  image = pipe(prompt, height=768, width=512, guidance_scale=7.5, num_inference_steps=100)["sample"][0]
  display(image)

 ということで、以下は呪文付きの作例です。もちろん、出来が比較的良いものだけ。
 全般的に雰囲気はいいけれどよく見るとツッコミどころがいろいろあり、というような画像が多数です。
 ちなみに、呪文(prompt)作成の際はDeepL翻訳を使うと便利ですよ。

oil painting, highly detailed, an old wizard reading a book in study, dramatic lighting

old wizard のキーワードは映画版のダンブルドアとガンダルフの要素が入った顔になりがちな気がする。
an old wizard reading a book in study01
an old wizard reading a book in study02

oil painting, highly detailed, a girl watching the sunset in the meadow, dramatic lighting

アメリカンな感じなものは学習元のデータが多いのか違和感のない出来のものが多い。
a girl watching the sunset in the meadow01
a girl watching the sunset in the meadow02
a girl watching the sunset in the meadow03
a girl watching the sunset in the meadow04

oil painting, highly detailed, children in the corn field, dramatic lighting

これも上と同様にアメリカンな感じ。
Children in the corn field01
Children in the corn field02

beautiful concept art of, highly detailed, children in the corn field, dramatic lighting

「oil paintg」を「concept art」というキーワードに変えると映画っぽい雰囲気になる。
Children in the corn field concept art01
Children in the corn field concept art03

beautiful concept art of, highly detailed, Asian girl standing on a street corner in a big city, dramatic lighting

コンセプトアートぽい雰囲気。
Asian girl standing on a street corner in a big city 01
Asian girl standing on a street corner in a big city 02

an old wizard in study, Ukiyoe style

浮世絵風のダンブルドア校長の生成を狙ったのだが、中国風の老人しか生成できず。もしかすると中国の仙人は英語だとold wizardと訳されるのか?
a old wizard in study 01
a young wizard  in study 02

beautiful concept art, highly detailed, a witch with cat's face, moonlit night, dramatic lighting

ネコ顔の魔女の生成を狙ったがなかなか狙い通りに行かず、何度か繰り返して3つほど成功。特に指定はしていないのだがなぜかお供の猫も一緒に生成される。
a witch with cat's face 01
a witch with cat's face 02
a witch with cat's face 03

illustration, highly detailed, a witch with cat's face, moonlit night, dramatic lighting

「concept art」を「illustration」に変えてみると、モノクロ調が増えてくる。
a witch with cat's face illustration 01
a witch with cat's face illustration 02
a witch with cat's face illustration 03

color illustration, highly detailed, a witch with cat's face, moonlit night, dramatic lighting

カラフルにできないかと「color illustration」にしてみたら、なぜか今ひとつな絵が増えた。その中で一番ましなものを。
a witch with cat's face color illustration

Ukiyoe style, highly detailed, a witch with cat's face, moonlit night, dramatic lighting

ネコ顔魔女の浮世絵風は何度繰り返してもうまくいかず。一番良かったのがこれ。
a witch with cat's face Ukiyoe

Hetauma style, highly detailed, a witch with cat's face, moonlit night, dramatic lighting

ヘタウマ風を狙ったら、なぜかアーティスティックなものが生成された。ヘタウマはやっぱりヘタでなくアートなのだろう。
a witch with cat's face Hetauma 01
a witch with cat's face Hetauma 02

beautiful concept art, highly detailed, an old lady crying at a rainy forest, dramatic lighting

雨の森の中で泣いている老婆、というものを生成しようと思ったら、木に埋まって泣いている老婆もついでに生成された……
an old lady crying at a rainy forest 01
an old lady crying at a rainy forest 02
an old lady crying at a rainy forest 03

beautiful concept art, highly detailed, a cat in a deerstalker hat, dramatic lighting

鹿撃ち帽(シャーロック・ホームズの帽子として有名ですね。原作には出てこないらしいですが)を被ったネコを生成したかったのですが、何度やっても鹿撃ち帽にはひとつもならず。
a cat in a deerstalker hat 01
a cat in a deerstalker hat 02

beautiful concept art, highly detailed, A beautiful silver-haired girl standing alone on a moonlit plain, dramatic lighting

なんとなく格好いい構図。
A beautiful silver-haired girl standing alone on a moonlit plain 01

beautiful concept art, highly detailed, A beautiful silver-haired girl standing alone on a moonlit plain, with a cat, dramatic lighting

これぐらいゆるい感じの方が誤魔化しがききやすいですね。左手とか変ですけど。
A beautiful silver-haired girl standing alone on a moonlit plain, with a cat

beautiful concept art, highly detailed, a silver-haired old lady with a cat, moonlit night, dramatic lighting

縦512、横768で横長の画像を生成。上の方にも書きましたが、一辺が512を超えると、画像領域が繰り返される(画像全体の首尾一貫性がとれなくなる)ため、失敗が増えます。手が増えたり、顔が増えたり、人物が重なったり。なので成功すると嬉しい。
a silver-haired old lady with a cat

beautiful concept art, highly detailed, a witch reading a book in study, dramatic lighting

こちらは縦768、横512の縦長。
a witch reading a book in study 02

oil painting, highly detailed, King of cats, dramatic lighting

King of cats

beautiful concept art, highly detailed, an old wizard sitting in study, with a cat, dramatic lighting

ネコと一緒に書斎でくつろぐ老魔術師、を想定していたのだが、なぜかネコと一緒に書斎でくつろぐネコ顔の老魔術師が生成される。下の画像は左手が多いように見えますが、たぶん足なのですよ。ネコだし。あるいは二人羽織。
an old wizard sitting in study 01
an old wizard sitting in study 03

2017年11月5日日曜日

Pythonに関する書籍の紹介

ガーデン
α6500 & Sonnar T* E 24mm F1.8 ZA SEL24F18Z

 Python関連で購入したり図書館で借りたりしたりして読んだ本の一覧と感想です。
 随時更新予定。

入門書

『実践力を身につける Pythonの教科書』

 自分は入門書としてこれを購入。
 わかりやすくPythonの基本がひと通り身につく。

『入門 Python 3』

 文法面は詳しく、また有用な標準ライブラリなどにも言及がある。上の本を読んだあとでも、役に立つ記述があるので一度読んでおくとよい。自分は図書館で借りた。

Python 3.6.3 Documentation

 Pythonの日本語ドキュメント。書籍ではなくて恐縮だが、読んでおいたほうがよいと思うので掲載。
 上の本を読んだあとにひととおり読んでおくと標準ライブラリにどんなものがあるかなんとなく頭に入るので、無駄な苦労をしなくてすむと思う。  

クローリング・スクレイピング関係

『Pythonによるスクレイピング&機械学習 開発テクニック BautifulSoup,scikit-learn,TensorFlowを使ってみよう』

 書名のとおり、スクレイピング、機械学習(含むディープラーニング)をひととおり体験できる。スクレイピングについて詳しく知りたい人は、最初から下の本を買うほうがよいかと思う。

『Pythonクローリング&スクレイピング -データ収集・解析のための実践開発ガイド- 』

 基本的なスクレイピング処理から自動での処理まで、相手先への負荷への配慮とか、エラーが出た場合の処理方法なども含めて載っている。
 下の本と両方手に入れたほうがよいが、どちらか一冊と言われたらこっちかな。

Pythonによるクローラー&スクレイピング入門 設計・開発から収集データの解析・運用まで

 こちらも基本的なスクレイピング処理から自動での処理まで記載されている。
 Scrapyについてもっと詳しく記載してほしかったのと、Web上で記載した記事の焼き直しのようなものもありそれに起因する誤植のようなものもあったのが減点要因。

機械学習・ディープラーニング

『Pythonによるスクレイピング&機械学習 開発テクニック BeautifulSoup,scikit-learn,TensorFlowを使ってみよう』

 再掲。機械学習やディープラーニングがどんなものか体験してみるには良い本。

その他

Effective Python ―Pythonプログラムを改良する59項目

 内容は高度。理解でない部分も多かったが、初心者のうちに目を通しておくと後で苦労が減りそうな感触がある。図書館で借りたが、手元に置いておきたいので後で買う予定。

PythonユーザのためのJupyter[実践]入門

 Jupyter Notebookを使ってのpandasによるデータ集計や、Matplotlib、Bokehによるデータ可視化を解説。Seabornについても解説されているとさらに嬉しかったのだったが、それはないものねだりですかね。。

2017年11月3日金曜日

【Python】簡易ドキュメントデータベース「TinyDB」を使ってみる

屋敷森
Ricoh GR

TinyDBとは

 Python用の簡易型のドキュメントデータベースです。
 サーバーを立てる必要がなく、データはJSON形式で保存されます。
 インストールもpipで簡単にできるので、ちょっとしたデータベースを作りたいときにお手軽に使えます。

 この記事では、自分用のメモを兼ねて簡単に使い方を記載します。
 詳しいドキュメントは「Welcome to TinyDB! — TinyDB 3.6.0 documentation」を御覧ください。

インストール方法

 pipで簡単にインストールできます。

pip install tinydb

使い方

ライブラリのインポート
from tinydb import TinyDB, Query
データベースの作成・オープン

 TinyDBメソッドにファイル名(必要ならパスを入れて)を引数で指定してデータベースを作成・オープンします。既にファイルがあれば開き、なければ新規に作成します。

# データベースの作成・オープン
db = TinyDB("db.json")

 なお、インメモリーで使う場合は、次のように開きます。

from tinydb.storages import MemoryStorage
db = TinyDB(storage=MemoryStorage)
テーブルの作成・指定

 データベースの中にテーブルを作成するとき(あるは既存のテーブルを開くとき)は、table() メソッドの引数で指定します。なお、テーブルを指定しないで使用することも可能です。この場合は「_default」というテーブルが使用されます。

tb_fruit = db.table("fruit")
tb_animal = db.table("animal")

 データベース内にあるテーブルの一覧は tables()メソッドで取得します。テーブルのリストが戻り値となります。

tables = db.tables()
データの追加

 一件ずつデータを追加するときは insert()メソッドに辞書を引数として渡します。
 後述しますが、戻り値としてドキュメントIDが返ります。
 テーブルを省略した形でデータベースから直接 insert()メソッドを使うと「_default」テーブルに追加されます。他のメソッドも同様です。

db.insert({"kind": "ネギ", "count": 1}) #テーブルを指定しない場合「_defaul」テーブルに追加される
tb_fruit.insert({"kind": "リンゴ", "count": 2})
tb_animal.insert({"kind": "サル", "count": 3})

 複数のデータを追加するときは、insert_multiple()メソッドを使います。引数は辞書のリスト、戻り値はドキュメントIDのリストとなります。

new_fruits = [{"kind": "オレンジ", "count": 4}, {"kind": "メロン", "count": 10}]
tb_fruit.insert_multiple(new_fruits)
new_animals = [{"kind": "キリン", "count": 2}, {"kind": "サル", "count": 10}]
tb_animal.insert_multiple(new_animals)
データの一覧出力 

 all()メソッドでテーブルのデータの一覧が出力されます。

# fruitテーブルのデータを一覧出力
tb_fruit.all()

#データベースに使用した場合は _defaultテーブルのデータが出力される
db.all()
データの検索

 検索にはQueryオブジェクトを使います。

query = Query()

# search()は該当するドキュメント(辞書)のリストが出力
tb_animal.search(query.kind == "サル")  # 該当するドキュメントのリストが出力
tb_fruit.search(query.kind == "キウイ")  # 該当するものがない場合は空のリストで出力
tb_fruit.search(query.count > 3) # 比較演算子が使える

# get()は該当する1件のみの出力
# 戻り値はドキュメント
tb_animal.get(query.kind == "サル")

# contains()は該当するドキュメントがあるか否か(戻り値は True / False)
tb_fruit.contains(query.kind == "オレンジ")
tb_fruit.contains(query.kind == "キウイ")

# count()は該当するドキュメントの数
print(tb_animal.count(query.kind == "サル"))
print("\n---------\n")
データの更新

 データの更新にはupdate()メソッドを使います。

# kindがキリンのドキュメントのcount値を1に更新
tb_animal.update({"count": 1}, query.kind == "キリン")

# 検索条件が複数ドキュメントに該当する場合はすべてのドキュメントが更新される
tb_animal.update({"count": 5}, query.kind == "サル")
データの削除

 データの削除にはremove()メソッドを使います。

# countが5未満のドキュメントを削除
tb_fruit.remove(query.count < 5)
ドキュメントID

 テーブル内の各ドキュメントにはそれぞれドキュメントIDが自動で振られます。
 insert()メソッドでデータ(ドキュメント)を挿入した場合の戻り値は挿入したドキュメントのIDとなり、insert_mulipleで挿入した場合の戻り値は挿入したドキュメントのIDのリストとなります。

# 挿入したデータにはドキュメントIDが振られる
id = tb_fruit.insert({"kind": "ブドウ", "count": 2})

# 複数挿入した場合はIDがリストで返る
new_fruits = [{"kind": "パパイヤ", "count": 12}, {"kind": "マンゴー", "count": 15}]
ids = tb_fruit.insert_multiple(new_fruits)
print("パパイヤとマンゴーのdocumentID: {0}".format(ids))

 既にテーブルにあるドキュメントのIDを取得したい場合は、ドキュメントのdoc_idプロパティから取得できます。

id = tb_fruit.get(query.kind == "メロン").doc_id  # documnet.doc_idでIDを取得

 get() は doc_id 引数、 contains()、 update()、 remove() はdoc_ids引数(IDのリスト)でドキュメントを指定できます。

# get()はdoc_id引数、 contains(), update(), remove()でdoc_ids引数で指定できる
tb_fruit.get(doc_id=id)
tb_fruit.update({"kind": "メロン", "count": 10, "size": "large"}, doc_ids=[id])
テーブル内のデータの個数

 Len()関数で引数にテーブルを指定するとテーブル内に含まれるデータの個数が返ります。

# fruitテーブルのデータの個数を出力
len(tb_fruit)

# データベースを指定すると _defaultテーブルおデータの個数が出力される
len(db)
テーブル内のすべてのデータの削除

 purge()メソッドでテーブル内のすべてのデータが削除されます。

tb_fruit.purge()
tb_animal.purge()
db.purge()  # _defaultテーブルのデータのみ適用される

サンプルコード

from pprint import pprint
from tinydb import TinyDB, Query

db_path = "db.json"

# データベースの作成・オープン
db = TinyDB(db_path)

# インメモリーで使う場合
# from tinydb.storages import MemoryStorage
# db = TinyDB(storage=MemoryStorage)


# テーブルの作成・指定(未指定の場合は_defaultというテーブルが使用される)
tb_fruit = db.table("fruit")
tb_animal = db.table("animal")

# データベースにあるテーブルの一覧リスト
tables = db.tables()
print("# データベースにあるテーブルの一覧リスト")
pprint(tables)
print("\n---------\n")

# 一件ずつのデータの追加
db.insert({"kind": "ネギ", "count": 1})
tb_fruit.insert({"kind": "リンゴ", "count": 2})
tb_animal.insert({"kind": "サル", "count": 3})

# 複数のデータの追加
new_fruits = [{"kind": "オレンジ", "count": 4}, {"kind": "メロン", "count": 10}]
tb_fruit.insert_multiple(new_fruits)
new_animals = [{"kind": "キリン", "count": 2}, {"kind": "サル", "count": 10}]
tb_animal.insert_multiple(new_animals)

# データの一覧出力
print("# データの一覧出力")
print("_defaultテーブルのデータ")
pprint(db.all())  # _defaultテーブルのデータのみ適用される
print("fruitテーブルのデータ")
pprint(tb_fruit.all())
print("animalテーブルのデータ")
pprint(tb_animal.all())
print("\n---------\n")

# データの検索
query = Query()
# search()は該当するものがリストで出力
print("# データの検索")
pprint(tb_animal.search(query.kind == "サル"))  # 該当するものがリストで出力
pprint(tb_fruit.search(query.kind == "キウイ"))  # 該当するものがない場合は空のリストで出力
pprint(tb_fruit.search(query.count > 3))
# get()は1件のみの出力
pprint(tb_animal.get(query.kind == "サル"))
# contains()は該当するものがあるか否か
print(tb_fruit.contains(query.kind == "オレンジ"))
print(tb_fruit.contains(query.kind == "キウイ"))
# count()は該当するものの数
print(tb_animal.count(query.kind == "サル"))
print("\n---------\n")

# データの更新
print("# データの更新")
tb_animal.update({"count": 1}, query.kind == "キリン")
tb_animal.update({"count": 5}, query.kind == "サル")  # 複数該当する場合はすべての項目で更新
pprint(tb_animal.all())
print("\n---------\n")

# データの削除
print("# データの削除")
tb_fruit.remove(query.count < 5)
pprint(tb_fruit.all())
print("\n---------\n")

# ドキュメントID
# 挿入したデータにはドキュメントIDが振られる
print("# ドキュメントID")
id = tb_fruit.insert({"kind": "ブドウ", "count": 2})
print("ブドウのdocumentID: {0}".format(id))

# 複数挿入した場合はidがリストで返る
new_fruits = [{"kind": "パパイヤ", "count": 12}, {"kind": "マンゴー", "count": 15}]
ids = tb_fruit.insert_multiple(new_fruits)
print("パパイヤとマンゴーのdocumentID: {0}".format(ids))

# documnet.doc_idでIDを取得
id = tb_fruit.get(query.kind == "メロン").doc_id
print("メロンのdocumentID: {0}".format(id))
print("\n---------\n")

# get()はdoc_id引数、 contains(), update(), remove()でdoc_ids引数で指定できる
print("# ドキュメントIDでのデータの指定")
print("doc_id:{0} は {1}".format(id, tb_fruit.get(doc_id=id)))
tb_fruit.update({"kind": "メロン", "count": 10, "size": "large"}, doc_ids=[id])
print("doc_id:{0} は {1}".format(id, tb_fruit.get(doc_id=id)))
print("\n---------\n")

# データの個数
print("# データの個数")
print("db(_defaultテーブル)のデータの個数 = {0}".format(len(db)))
print("fruitテーブルのデータの個数 = {0}".format(len(tb_fruit)))
print("animalテーブルのデータの個数 = {0}".format(len(tb_animal)))
print("\n---------\n")

# すべてのデータの削除
print("# すべてのデータの削除")
db.purge()  # _defaultテーブルのデータのみ適用される
tb_fruit.purge()
tb_animal.purge()
print("_defaultテーブルのデータ")
pprint(db.all())
print("fruitテーブルのデータ")
pprint(tb_fruit.all())
print("animalテーブルのデータ")
pprint(tb_animal.all())
print("\n---------\n")

2017年10月22日日曜日

【Python】芥川龍之介の『鼻』からワードクラウドを作ってみる

nose

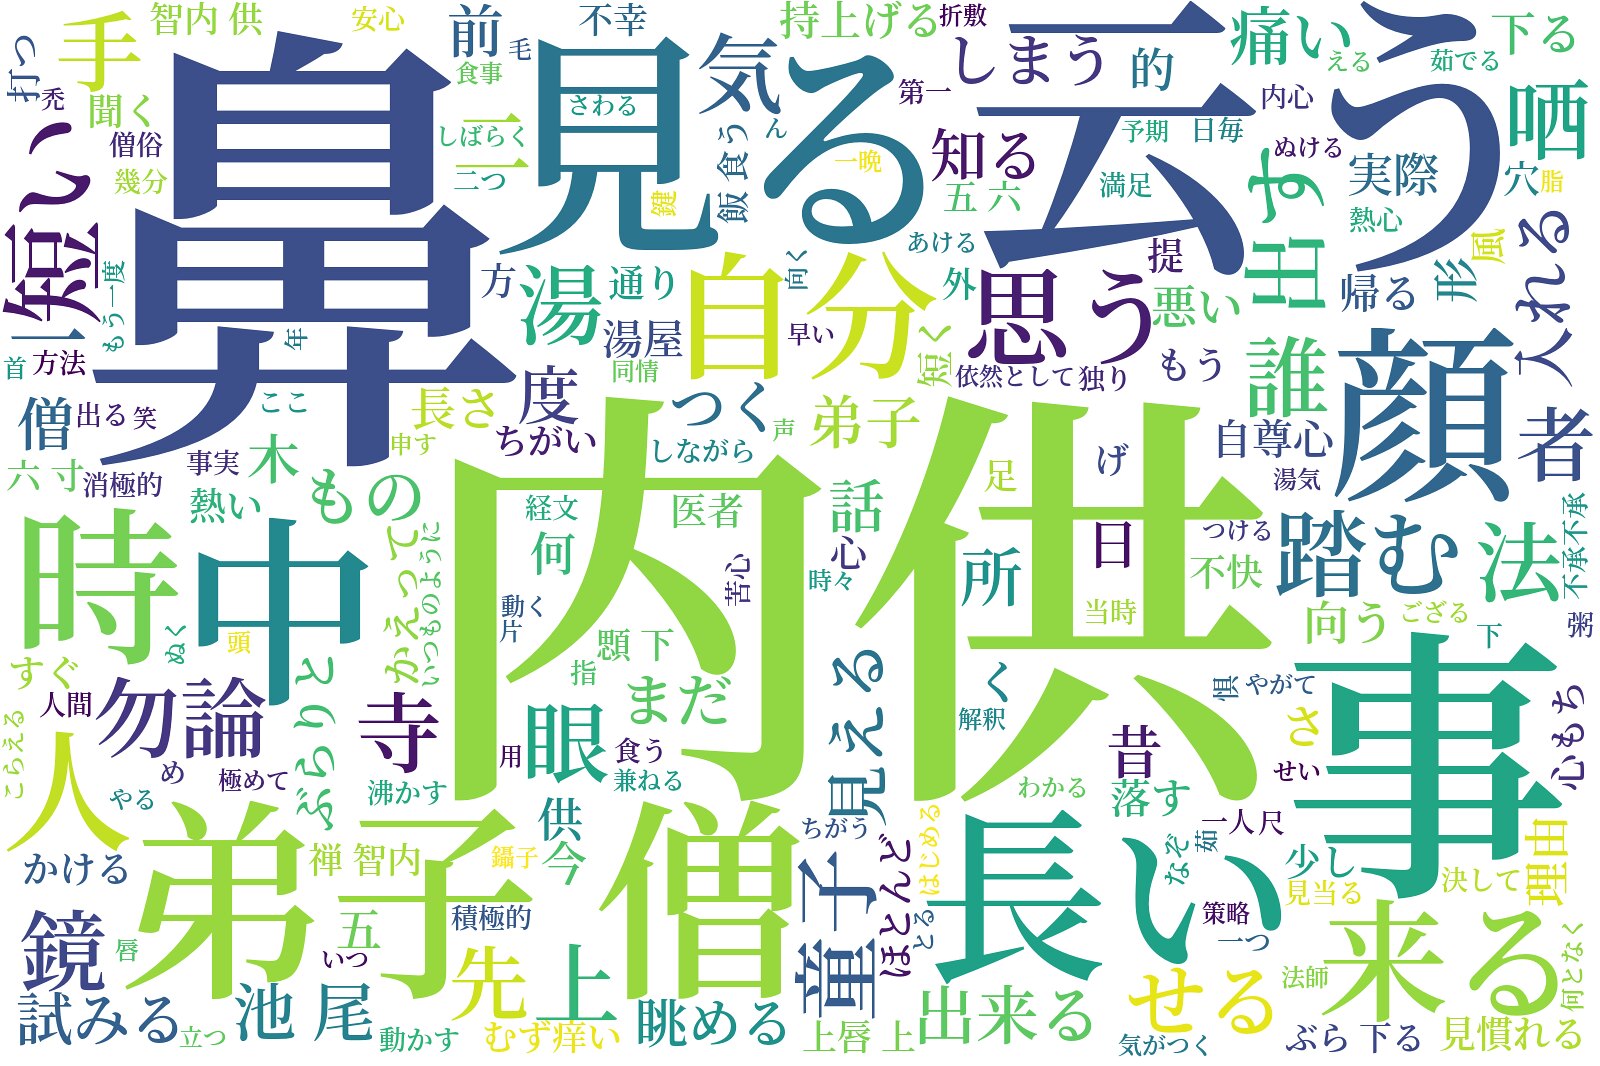
 『Pythonによるクローラー&スクレイピング入門 設計・開発から収集データの解析・運用まで』P283~を参考にして芥川龍之介の『鼻』のテキストから上のようなワードクラウドを作成してみました。
 書籍掲載のものは形態素解析にJanomeを使用していますが、今回はMeCabで行っています。辞書はipadic-neologdを使用。
 また、名詞、副詞、動詞、形容詞のみ抽出し、動詞・形容詞は基礎型に変換しています。


import requests
import MeCab
from bs4 import BeautifulSoup
from wordcloud import WordCloud
import matplotlib.pyplot as plt


def get_wordcloud(text, file_path):
    '''
    :param text, file_path: str
    :return:
    '''

    # ストップワードの設定。出力結果を見ながら手動で設定した。
    stop_words = ["ある", "ない", "いる", "する", "の", "よう", "なる", "それ", "そこ", "これ", "こう", "ため", "そう", "れる", "られる"]

    # 単語に分割し名詞、副詞、動詞、形容詞のみ抽出(動詞・形容詞は基礎型を取得)
    tagger = MeCab.Tagger('-Ochasen')
    pos1 = ("名詞", "副詞")  # 表層形を取得する品詞
    pos2 = ("動詞", "形容詞")  # 基礎形を取得する品詞
    node = tagger.parseToNode(text)
    words = []
    while node:
        features = node.feature.split(",")
        if (features[0] in pos1) and not (node.surface in stop_words):
            words.append(node.surface)
        elif (features[0] in pos2) and not (features[6] in stop_words):
            words.append(features[6])
        node = node.next

    # wordcloudオブジェクトの作成
    font_path = r"C:\WINDOWS\Fonts\SourceHanSerif-SemiBold.otf"
    wordcloud = WordCloud(background_color="white", font_path=font_path, width=1600, height=1066, regexp=r"\w+").generate(" ".join(words))

    # wordcloudファイル出力
    wordcloud.to_file(file_path)

    # wordcloud表示
    plt.imshow(wordcloud, interpolation="bilinear")
    plt.axis("off")
    plt.show()


if __name__ == '__main__':
    # 青空文庫からテキストの取得
    url = "http://www.aozora.gr.jp/cards/000879/files/42_15228.html"  # 芥川龍之介 『鼻』
    r = requests.get(url, timeout=10)
    soup = BeautifulSoup(r.content, "lxml")

    # 本文の抽出
    text_elm = soup.find("div", attrs={"class": "main_text"})

    # ルビの削除
    [e.extract() for e in text_elm.select("rt")]
    text = text_elm.text

    # wordcloudの作成
    file_path = r"D:\nose.png"  # 出力する画像ファイルのパス
    get_wordcloud(text, file_path)

2017年10月13日金曜日

【Python】Windowsでなるべく楽にMeCabをインストールする

花束
α6500 & E 50mm F1.8 OSS SEL50F18

 Pythonで形態素解析をしようと考えたとき、まず最初に選択肢にあがるツールはMeCabだと思います。
 しかしながら、WindowsでMeCabを使うのは、特に64bit版を使うのは意外と準備が面倒。

 というわけで、当初はpipで簡単にインストールできるJanomeを使っていたのですが、小さなデータならともかく大きなデータを扱うには残念ながら処理速度が足りませんでした。
 試しに10MBぐらいのテキストファイルで含まれる名詞の出現数を数える処理をしてみたら(joblibでcorei7論理8コアでの並列処理)、janome(mecab-ipadic-neologd内包版)で3分15秒程度かかりました。GB単位のデータを処理するにはちょっと大変そうです。

 そこで、仕方なく、ネットで検索しながら64bit版MeCab(加えて「mecab-ipadic-NEologd」も)を頑張ってインストールしてみましたので、備忘録として書き残します。先人に感謝。

64bit版MeCabをインストールする

 MeCabの公式サイト(MeCab: Yet Another Part-of-Speech and Morphological Analyzer)では、Windows用の64bit版MeCabは配布されていません。
 知識がある方ならソースコードを元に64bit版を自分で作成できるようですが(知識がなくても先人のものを参考にしながらなら不可能ではなさそうですが)、なるべく楽をしたいので、先人が作成してくださったReleases · ikegami-yukino/mecab · GitHubからMeCabの64bit版をダウンロードしてインストールします。

環境変数を設定する

 環境変数PATHに「\bin」を追加し、環境変数MECABRCに「\etc\mecabrc」を設定します。MECABRCがないとPythonからMeCabを使用する際にエラーが出ます。

Pythonにmecab-pythonを入れる

 一般的に使われる「mecab-python」は、Windowsではそのままpipでインストールとはいきません。ソースをダウンロードしてsetup.pyを書き換えてコンパイラをインストールしてetcの作業が必要になります。
 そこで、先人が作成してくださったWindows用のパッケージであるmecab-python-windows 0.9.9.6 : Python Package Indexを使用させていただいたのですが、前処理をしないとこれもそのままではpipでインストールできませんでした。

  1. Visual C 2015 Build Tools([Download the Visual C Build Tools (standalone C++ compiler, libraries and tools)](http://landinghub.visualstudio.com/visual-cpp-build-tools))のインストール
  2. 「\sdk」の「C:\Program Files (x86)\MeCab\sdk」へのコピー

の2つの作業が必要になります。この作業をしておくと、コマンドプロンプトから「pip install mecab-python-windows」でインストールできます。

mecab-ipadic-NEologdをインストール

 mecab-ipadic-NEologdは、多数のWeb上の言語資源から得た新語を追加したMeCab用の辞書です。本やマンガのタイトルなど固有名詞を分割させないようにするには必須。
 これをインストールするには「Bash on Ubuntu on Windows」を使います。
 まず、「Bash on Ubuntu on Windowsをインストールしてみよう! - Qiita」などを参考にして、「Bash on Ubuntu on Windows」を導入します。
 次に「mecab-ipadic-neologd/README.ja.md at master · neologd/mecab-ipadic-neologd · GitHub」の「Windows 10 バージョン 1607 以降の場合」の項のとおりに「mecab-ipadic-NEologd」をインストールします。
 インストールした際に、git cloneしたディレクトリ配下に「build\mecab-ipadic-2.7.0-20070801-neologd-日付」というディレクトリができます。この中にmecab-ipadic-NEologdの辞書が入っています。
 最後に「\ipadic」の中身を上記ディレクトリの中身と入れ替えれば完成。
 なお、入れ替えなくても-dオプションで辞書を指定すれば使えますが(例:tagger = MeCab.Tagger(r"-Owakati -d C:\src\mecab-ipadic-neologd\build\mecab-ipadic-2.7.0-20070801-neologd-20171009"))、そのたびに指定するのも面倒なので、私は標準辞書のディレクトリ名をipadic_oldと変更して残した上で入れ替えちゃってます。

おまけ:JanomeとMeCabの速度差

 冒頭で述べた約10MBのテキストファイルに含まれる名詞の出現数を数える処理(joblibでcorei7論理8コアでの並列処理)ですが、Janomeで3分15秒ぐらいかかっていたものが、MeCabで同等の作業をしたら2~3秒で終了!
 スピード差は10倍どころか少なくとも50倍以上はありそうです。

2017年9月17日日曜日

【Python】「言語処理100本ノック 2015」を始めてみました

夏の一コマ
α6500 & SIGMA 35mm F1.4 DG HSM Art

 言語処理100本ノック 2015を始めてみました。
 まずは「第1章: 準備運動」からですが、準備運動でもプログラミング素人にはなかなか大変です。
 環境は、Windows10 + Anaconda3.4.4 です。

00. 文字列の逆順

文字列”stressed”の文字を逆に(末尾から先頭に向かって)並べた文字列を得よ.

s = "stressed"
ans = s[::-1]
print(ans)

# > desserts

文字列のスライスのステップを使ってみました。
ステップに-数値を指定すると逆順にステップします。
ちなみに、スライスで指定する数字は、要素(文字列なら文字)の位置ではなく、要素と要素の間(ナイフを入れて切るところ)と考えると理解しやすかったです。

01. 「パタトクカシーー」

「パタトクカシーー」という文字列の1,3,5,7文字目を取り出して連結した文字列を得よ.

s = "パタトクカシーー"
ans = s[::2]
print(ans)

# > パトカー

むしろこちらの方が1問目に相応しいような気がする問題。
文字列のスライスのステップを知っていれば簡単ですね。

02. 「パトカー」+「タクシー」=「パタトクカシーー」

「パトカー」+「タクシー」の文字を先頭から交互に連結して文字列「パタトクカシーー」を得よ.

s1 = "パトカー"
s2 = "タクシー"
ans = "".join([c1 + c2 for c1, c2 in zip(s1, s2)])
print(ans)

# > パタトクカシーー

リスト内包表記を使用しています。for文より処理速度が速いとのことなので、使えるときは内包表記を使用するように心がけています。
“区切り文字列”.join(文字列のリスト)で区切り文字列を挟んで文字列のリストを結合した文字列を得られます(上の例は空文字列で結合)。
zip()は複数のシーケンスオブジェクトを同時にループしたいときに便利。要素数が違う場合は一番少ないものに合わせられます。

03. 円周率

“Now I need a drink, alcoholic of course, after the heavy lectures involving quantum mechanics.”という文を単語に分解し,各単語の(アルファベットの)文字数を先頭から出現順に並べたリストを作成せよ.

s = "Now I need a drink, alcoholic of course, after the heavy lectures involving quantum mechanics."
ans = [len(word.strip(",.")) for word in s.split()]
print(ans)

# > [3, 1, 4, 1, 5, 9, 2, 6, 5, 3, 5, 8, 9, 7, 9]

文字列をsplit()で区切ってリストにしてから”,”と”.”をstrip()で除去。リスト内包表記でリスト化しています。
“文字列A”.split(“区切り文字”)で文字列Aを区切り文字列で区切った文字列のリストを得ることができます(区切り文字列は除去される)。区切り文字を指定しない場合は空白文字(半角スペース、全角スペース、改行、改ページ、タブ、垂直タブ、復帰)が区切り文字として扱われます。
strip()は文字列の両端から指定した文字列を削除するメソッドです。
len()はシーケンスの要素数を返す関数ですね。

04. 元素記号

“Hi He Lied Because Boron Could Not Oxidize Fluorine. New Nations Might Also Sign Peace Security Clause. Arthur King Can.”という文を単語に分解し,1, 5, 6, 7, 8, 9, 15, 16, 19番目の単語は先頭の1文字,それ以外の単語は先頭に2文字を取り出し,取り出した文字列から単語の位置(先頭から何番目の単語か)への連想配列(辞書型もしくはマップ型)を作成せよ.

s = "Hi He Lied Because Boron Could Not Oxidize Fluorine. New Nations Might Also Sign Peace Security Clause. Arthur King Can."
ans = {word[:1] if i in [1, 5, 6, 7, 8, 9, 15, 16, 19] else word[:2]: i for i, word in enumerate(s.split(), start=1)}
print(ans)

# > {'H': 1, 'He': 2, 'Li': 3, 'Be': 4, 'B': 5, 'C': 6, 'N': 7, 'O': 8, 'F': 9, 'Ne': 10, 'Na': 11, 'Mi': 12, 'Al': 13, 'Si': 14, 'P': 15, 'S': 16, 'Cl': 17, 'Ar': 18, 'K': 19, 'Ca': 20}

split()メソッドでリスト化してから条件式(三項演算子)と内包表記で辞書型にまとめています。
enumerate関数はfor文でループ処理をするときカウンターと要素の両方を取得できる関数です。startでカウンターの初期値を指定できます(何も指定しないと0からスタート)。

05. n-gram

与えられたシーケンス(文字列やリストなど)からn-gramを作る関数を作成せよ.この関数を用い,”I am an NLPer”という文から単語bi-gram,文字bi-gramを得よ.

# 単語n-gram
def w_n_gram(n, text):
    words = [word.strip(",.") for word in text.split()]
    return [words[i:i + n] for i in range(len(words) - n + 1)]

# 文字n-gram
def c_n_gram(n, text):
    return [text[i:i + n] for i in range(len(text) - n + 1)]

s = "I am an NLPer"
ans1 = c_n_gram(2, s)
ans2 = w_n_gram(2, s)
print(ans1)
print(ans2)

# > ['I ', ' a', 'am', 'm ', ' a', 'an', 'n ', ' N', 'NL', 'LP', 'Pe', 'er']
# > [['I', 'am'], ['am', 'an'], ['an', 'NLPer']]

n-gramの意味が分からなくて検索してしまいました。
問題で指定された文字列だけでいうなら、単語n-gramのstrip(“,.”)は要らないですね。逆により汎用化するなら”;”や”:”など必要な記号を列記する必要があります。

06. 集合

“paraparaparadise”と”paragraph”に含まれる文字bi-gramの集合を,それぞれ, XとYとして求め,XとYの和集合,積集合,差集合を求めよ.さらに,’se’というbi-gramがXおよびYに含まれるかどうかを調べよ.

s1 = "paraparaparadise"
s2 = "paragraph"

# 文字bi-gram
def get_bi_gram(text):
    return {text[i:i + 2] for i in range(len(text) - 1)}

x = get_bi_gram(s1)
y = get_bi_gram(s2)

print("X: {0}".format(x))
print("Y: {0}".format(y))
print("和集合: {0}".format(x | y))
print("積集合: {0}".format(x & y))
print("差集合: {0}".format(x - y))
print("Xに'se'は含まれるか? {0}".format('se' in x))
print("Yに'se'は含まれるか? {0}".format('se' in y))

# > X: {'ad', 'ra', 'is', 'ar', 'se', 'ap', 'pa', 'di'}
# > Y: {'ra', 'ag', 'ar', 'ap', 'ph', 'pa', 'gr'}
# > 和集合: {'is', 'se', 'gr', 'ad', 'ra', 'ag', 'ar', 'ap', 'ph', 'pa', 'di'}
# > 積集合: {'pa', 'ap', 'ar', 'ra'}
# > 差集合: {'ad', 'is', 'di', 'se'}
# > Xに'se'は含まれるか? True
# > Yに'se'は含まれるか? False

題名のとおり集合型を使う問題ですね。
今回はbi-gram限定ですので、集合型のbi-gramを返す関数を作って対応しています。内包表記を使えば一行で済むものなので、関数にする必要性も薄いような気もしますが。
あとは集合型の演算方法さえ知っていればOK。

07. テンプレートによる文生成

引数x, y, zを受け取り「x時のyはz」という文字列を返す関数を実装せよ.さらに,x=12, y=”気温”, z=22.4として,実行結果を確認せよ.

def xyz(x, y, z):
    return "{0}時の{1}は{2}".format(x, y, z)

x = 12
y = "気温"
z = 22.4
print(xyz(x, y, z))

# > 12時の気温は22.4

なんだか拍子抜けする問題。
format()メソッドの使用方法さえ知っていれば簡単。

08. 暗号文

与えられた文字列の各文字を,以下の仕様で変換する関数cipherを実装せよ.

  • 英小文字ならば(219 - 文字コード)の文字に置換
  • その他の文字はそのまま出力

この関数を用い,英語のメッセージを暗号化・復号化せよ.

def cipher(text):
    return "".join([chr(219-ord(c)) if c.islower() else c for c in text])

s = "I couldn't believe that I could actually understand what I was reading : the phenomenal power of the human mind."
s_ciphered = cipher(s)
print("原文: {0}".format(s))
print("暗号化後: {0}".format(s_ciphered))
print("復号化後: {0}".format(cipher(s_ciphered)))

# > 原文: I couldn't believe that I could actually understand what I was reading : the phenomenal power of the human mind.
# > 暗号化後: I xlfowm'g yvorvev gszg I xlfow zxgfzoob fmwvihgzmw dszg I dzh ivzwrmt : gsv ksvmlnvmzo kldvi lu gsv sfnzm nrmw.
# > 復号化後: I couldn't believe that I could actually understand what I was reading : the phenomenal power of the human mind.

リスト内包表記と条件式(三項演算子)で文字列を1文字ずつ指定の処理をしてリスト化したものをjoin()メソッドで結合しています。
islower()は文字列がアルファベットの小文字かどうかを判定するメソッド。
chrは文字コードから文字を返す関数、ord()は文字から文字コードを返す関数です。

09. Typoglycemia

スペースで区切られた単語列に対して,各単語の先頭と末尾の文字は残し,それ以外の文字の順序をランダムに並び替えるプログラムを作成せよ.ただし,長さが4以下の単語は並び替えないこととする.適当な英語の文(例えば”I couldn’t believe that I could actually understand what I was reading : the phenomenal power of the human mind .”)を与え,その実行結果を確認せよ.

from random import shuffle

def randomize_text(text):
    words = [randomize_word(word) for word in text.split()]
    return " ".join(words)

def randomize_word(word):
    if len(word) <= 4:
        return word
    else:
        mid_char = [c for c in word[1:-1]]
        shuffle(mid_char)
        return word[:1] + "".join(mid_char) + word[-1:]

s = "I couldn't believe that I could actually understand what I was reading : the phenomenal power of the human mind ."
print(randomize_text(s))

# > I cd'nolut bvlieee that I cluod atlaulcy unendatsrd what I was radneig : the pomnaheenl pweor of the hmuan mind .

問題文から”.”や”:”もスペースで区切られていることを前提に作成。
まずsplit()で文を単語のリスト化。
次に4文字以上の単語の先頭と末尾を除いたものを文字のリストとしてから、randomモジュールのshuffleを使ってランダムに並び替え。
先頭と末尾を戻して再結合して単語を作り、最後にスペースを区切りにして単語のリストを結合して文に再構築しています。